Pandas I & 딥러닝 학습방법 이해하기
Pandas와 MLP basic
panel data 의 줄임말인 pandas는 파이썬의 데이터 처리의 사실상의 표준인 라이브러리입니다.
pandas는 파이썬에서 일종의 엑셀과 같은 역할을 하여 데이터를 전처리하거나 통계 처리시 많이 활용하는 피봇 테이블 등의 기능을 사용할 때 쓸 수 있습니다. pandas 역시 numpy를 기반으로 하여 개발되어 있으며, R의 데이터 처리 기법을 참고하여 많은 함수가 구성되어 있거 기존 R 사용자들도 쉽게 해당 모듈을 사용할 수 있도록 지원하고 있습니다.
0. Pandas overview
- 구조화된 데이터의 처리를 지원하는 파이썬 라이브러리
- panel data의 약자
- 고성능 array 계산 라이브러리인 numpy와 통합하여, 강력한 ‘스프레드시트’ 처리 기능을 제공한다.
- 인덱싱, 연산용 함수, 전처리 함수 등을 제공함
- 데이터 처리 및 통계 분석을 위해 사용
0.1. 데이터 로딩
pd.read_csv를 이용해 데이터를 로드할 수 있다.- url 형식으로 웹의 데이터를 로드할 수 있다.
sep옵션 : txt 형식의 데이터를 나눠주는 split 요소를 설정함으로써 데이터를 분리시켜줌- 몰랐던 옵션 :
\s+- 불규칙하게 연속된 single space를 분리해줌.
- 몰랐던 옵션 :
1. Series
-
DataFrame : Data Table 전체를 포함하는 object의 이름
-
Series : 데이터프레임 중 하나의 column에 해당하는 데이터의 모음 object를 말한다.
-
column vector를 표현하는 object
-
List to series
-
list = [1,2,3,4,5]
example_series = Series(data = list)
-
-
Dict to series
-
dict = {'a':1, 'b':2, 'c':3, 'd':4}
example_series = Series(data = dict)
-
-
인덱스에 접근할 때는 리스트의 인덱스 및 array의 인덱싱과 비슷하다.
# 2. DataFrame
- 메모리 구조는 index와 columns를 통해 접근하는 방식으로 이뤄져있다.
- 보통은
pd.DataFrame보다는pd.read_csv를 통해 한번에 데이터 프레임을 로드한다.
2.1. DataFrame 생성
-
# Example from - https://chrisalbon.com/python/pandas_map_values_to_values.html raw_data = { "first_name": ["Jason", "Molly", "Tina", "Jake", "Amy"], "last_name": ["Miller", "Jacobson", "Ali", "Milner", "Cooze"], "age": [42, 52, 36, 24, 73], "city": ["San Francisco", "Baltimore", "Miami", "Douglas", "Boston"], } df = pd.DataFrame(raw_data, columns=["first_name", "last_name", "age", "city"]) df -
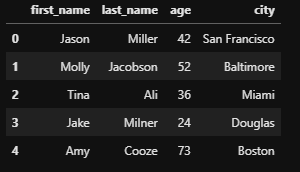
-
데이터프레임이 갖고 있지 않은 index 및 column명을 호출해주면 그 값들이
NaN으로 채워진다.
2.2. DataFrame indexing
- 해당 값에 접근하는 방식은 두 가지가 있다.
df.loc['인덱스명']: location이라는 의미로, 인덱스의 위치 즉 몇 번째인지를 의미하는 것이 아니라, 인덱스의 이름 그 자체를 찾는다.df.iloc[인덱스 넘버]: index location이라는 의미. 인덱스의 이름과 상관없이 몇 번째인지를 찾는다.
- 예제 코드
2.3. DataFrame handling
-
새 Series에 boolean을 통한 데이터 값을 새로 할당할 수 있다.
df.debt=df.age > 40df.age의 값이 40 초과면 True, 아니면 False를 df.debt에 새로 입력
-
T: 데이터프레임 transpose -
to_csv: csv로 저장 -
df.values: array 형태로 데이터프레임의 값들을 출력한다.
3. selection and drop
- 예제 코드
- 1개의 컬럼을 추출 :
df.col1ordf['col1']- 이 경우 데이터의 반환 형태가 Series
- 여러개의 컬럼 추출 :
df[['col1','col2]]- 이 경우 데이터의 반환 형태가 DataFrame
- selection :
df[조건1]: 조건1의 부울이 True인 조건에 해당하는 df의 값들이 출력된다.
- basic, loc, iloc selection
df[["name", "street"]][:2]
df.loc[[211829, 320563], ["name", "street"]]
df.iloc[:10, :3]
4. Decomposition of NN’s formula
이전 강의에서 배웠던 선형모델은 단순한 데이터를 해석할 때는 유용하지만 분류문제나 좀 더 복잡한 패턴의 문제를 풀 때는 예측성공률이 높지 않습니다. 이를 개선하기 위한 비선형 모델인 신경망을 본 강의에서 소개합니다.
신경망의 구조와 내부에서 사용되는 softmax, 활성함수, 역전파 알고리즘에 대해 설명합니다.
딥러닝은 여러 층의 선형모델과 활성함수에 대한 합성함수로 볼 수 있으며, 이 합성함수의 그래디언트를 계산하기 위해서 연쇄법칙을 적용한 역전파 알고리즘을 사용합니다. 이와 같은 딥러닝의 원리를 꼭 이해하시고 넘어가셨으면 좋겠습니다.
Further Question
분류 문제에서 softmax 함수가 사용되는 이유가 뭘까요? softmax 함수의 결과값을 분류 모델의 학습에 어떤식으로 사용할 수 있을까요?
선형모델 review
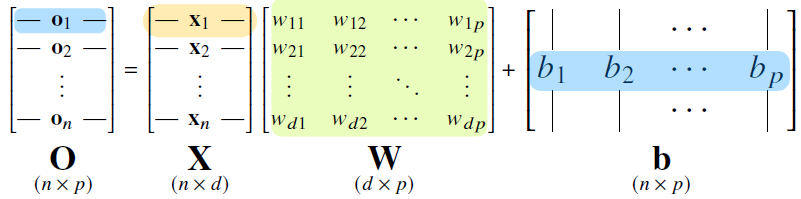
위와 같은 형태의 벡터 및 행렬의 곱으로 이루어진 모델을 말한다.
- : 각 행벡터
- : 데이터
- : 가중치 행렬
- : 절편 벡터 (bias)
여기서 의 차원인 차원은 output의 차원으로 바뀌게 된다. 이는 개의 변수로 개의 선형모델을 만들어서 개의 잠재변수를 설명하는 모델을 상상해볼 수 있다.
4.1.Nonlinear neural network - Softmax
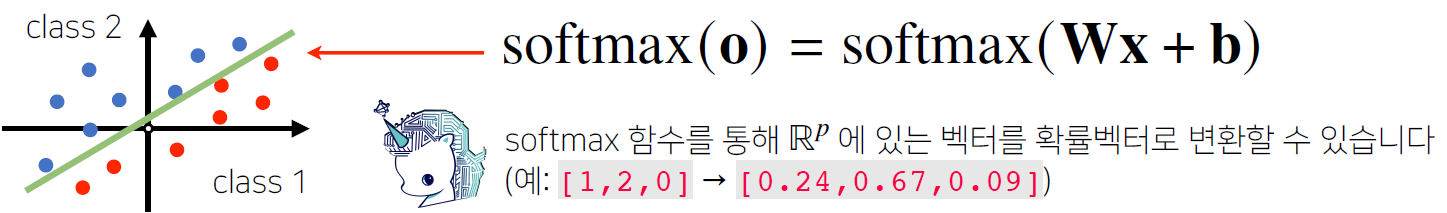
출력 벡터 에 softmax 함수를 합성하면 확률벡터가 되므로 특정 클래스 에 속할 확률로 해석이 가능하다
-
소프트맥스 함수는 모델의 출력을 확률로 해석할 수 있게 변환해주는 연산이다.
-
Classification task를 풀 때 선형모델과 소프트맥스 함수를 결합하여 예측합니다.
 def softmax(vec):
     denumerator = np.exp(vec - np.max(vec, axis=-1, keepdims = True))
     numerator = np.sum(denumerator, axis = -1, keepdims = True)
     val = denumerator / numerator
     return val
 vec = np.array([[1,2,0],[-1,0,1],[-10,0,10]])
 softmax(vec)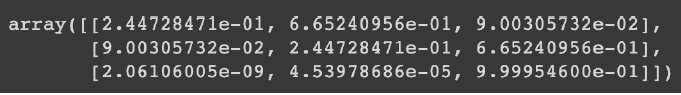
-
단, 학습이아닌
Inference를 수행하는 과정에서는 굳이 softmax를 사용하지는 않는다.- 어차피 one-hot-encoding에 argmax가 포함되어 있기 때문
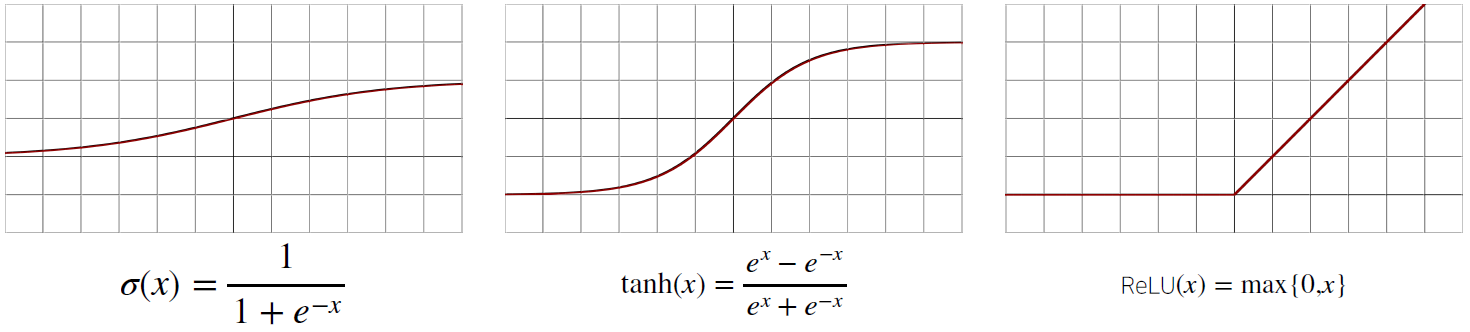
## 4.2. Activation func. - 신경망은 선형모델과 활성화함수를 합성한 함수이다. - 선형모델의 결과인 output vector에 적절한 activation function을 합성하여 원하는 작업을 수행하는 비선형 모델로 만든다. 즉, 활성화함수 $\sigma$는 비선형함수로써, `latent vector` $\mathbf{z} = (z_1, \dots, z_q)$의 각 노드에 개별적으로 적용한 새로운 `New latent vector` $\mathbf{H} = (\sigma(z_1), \dots, \sigma(z_q))$를 만든다.
## 4.3. what is Activation function? - 활성함수는 $\mathcal{R}$ 위에 정의된 `non-linear`함수로써 딥러닝에서 매우 중요한 개념입니다. - 활성함수를 쓰지 않으면 딥러닝은 선형모형과 차이가 없습니다. - 시그모이드(sigmoid) 함수나 tanh 함수는 전통적으로 쓰이던 활성함수지만 딥러닝에선 ReLU를 많이 쓰고있다.
4.4. Multi-layer Perceptron
-
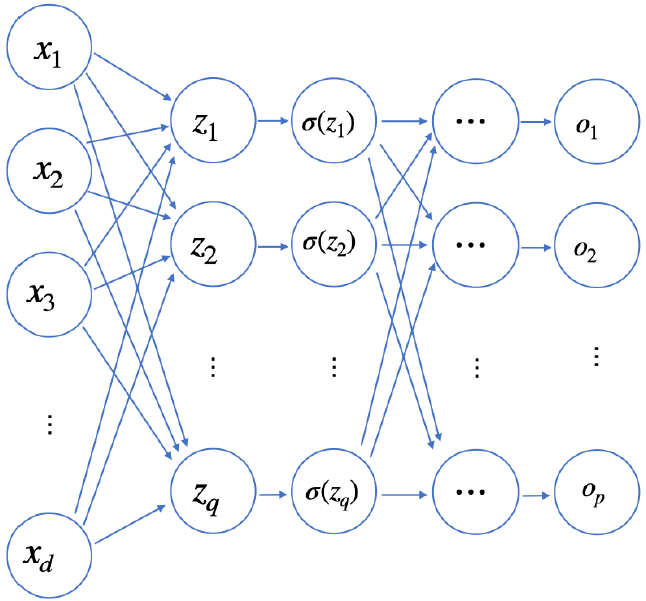
1개의 선형모델 + 1개의 활성화 함수가 아닌, 여러개의 선형모델+활성화함수로 이루어진 함수를 의미한다.
-
좌측에서 우측방향으로
input vector 는 선형모델을 거쳐(, ) output vector 는 비활성함수 를 거쳐 새로운 latent vector 가 된다. 이와 비슷한 방식의 두 번째 선형모델과 활성화함수를 거쳐 번째 latent vector 이 되고, 이러한 모델을
multi layer perceptron이라고 한다. -
이론적으로 2-layer NN은 임의의 연속함수를 근사할 수 있다.
- universal approximation theorem
-
층을 여러개 쌓는 이유?
- 층이 깊을수록 목적함수를 근사하는 데 필요한 뉴런(노드)의 숫자가 훨씬 빨리 줄어들어 좀 더 효율적으로 학습이 가능하다..
- 반대로 층이 얇으면 필요한 뉴런의 숫자가 기하급수적으로 늘어나서 넓은 신경망이 되어야만 한다.
1.5. Backpropagation
- 딥러닝은 역전파를 이용하여 각 층에 사용된 파라미터를 학습한다.
- 여기서 파라미터란
- 손실함수(Loss func. 혹은 Cost func.)를 이라 했을 때 역전파는 / 정보를 계산할 때 사용된다.
- 역전파는 Chain Rule을 이용하여 윗층(마지막 층)부터 input 방향으로 거꾸로 계산하게 된다.